面向分子数据分布的表示学习与生成模型
主讲人
倪雨嫣
中国科学院
时间
2026年5月25日 星期一
下午 14:00-15:00
地点
学院104会议室
Abstract
人工智能驱动的科学发现(AI for Science)正深刻变革基础科学的研究范式。分子科学的两大核心任务——性质预测与分子设计,在方法层面分别对应于表示学习与生成建模,其核心挑战均在于如何精确建模复杂的分子数据分布。分子数据受物理势能函数约束并遵循玻尔兹曼分布,其分布具有各向异性、尖峰性等特性,这些特性对表示学习与生成建模带来挑战。本次报告将基于我在博士期间的研究成果,从分子分布特性出发,分别探讨表示学习与生成建模的系统性方法。
在表示学习方面,针对现有坐标去噪方法难以刻画各向异性分布的局限,我们提出分数去噪预训练框架,通过理论上将原子力学习目标与噪声分布形式进行解耦,实现了对分子势能面的有效建模与广泛探索。为进一步提升建模精度,我们通过引入经典力学的势能函数并利用随机切片技巧,提升了微观结构细节的刻画能力与运算效率。在分子生成方面,我们提出直线扩散模型,通过优化训练阶段的噪声调度,使采样轨迹趋近线性化,在不增加计算复杂度的前提下大幅提升采样效率,且该调度高度契合分子分布的尖峰特性。针对采样阶段,我们进一步提出了随机性调控与温度退火框架,实现对初始采样误差的有效修正与物理低能区的精准聚焦,进一步提升生成分子的合法性。 我们的方法在性质预测与分子生成等多个任务上取得领先性能,展现出对不同分子体系及各类下游任务的通用潜力,并为未来构建兼具理解与生成能力、跨尺度的分子基础模型奠定了科学基础,有望为药物研发与新材料发现注入新的动能。
Biography
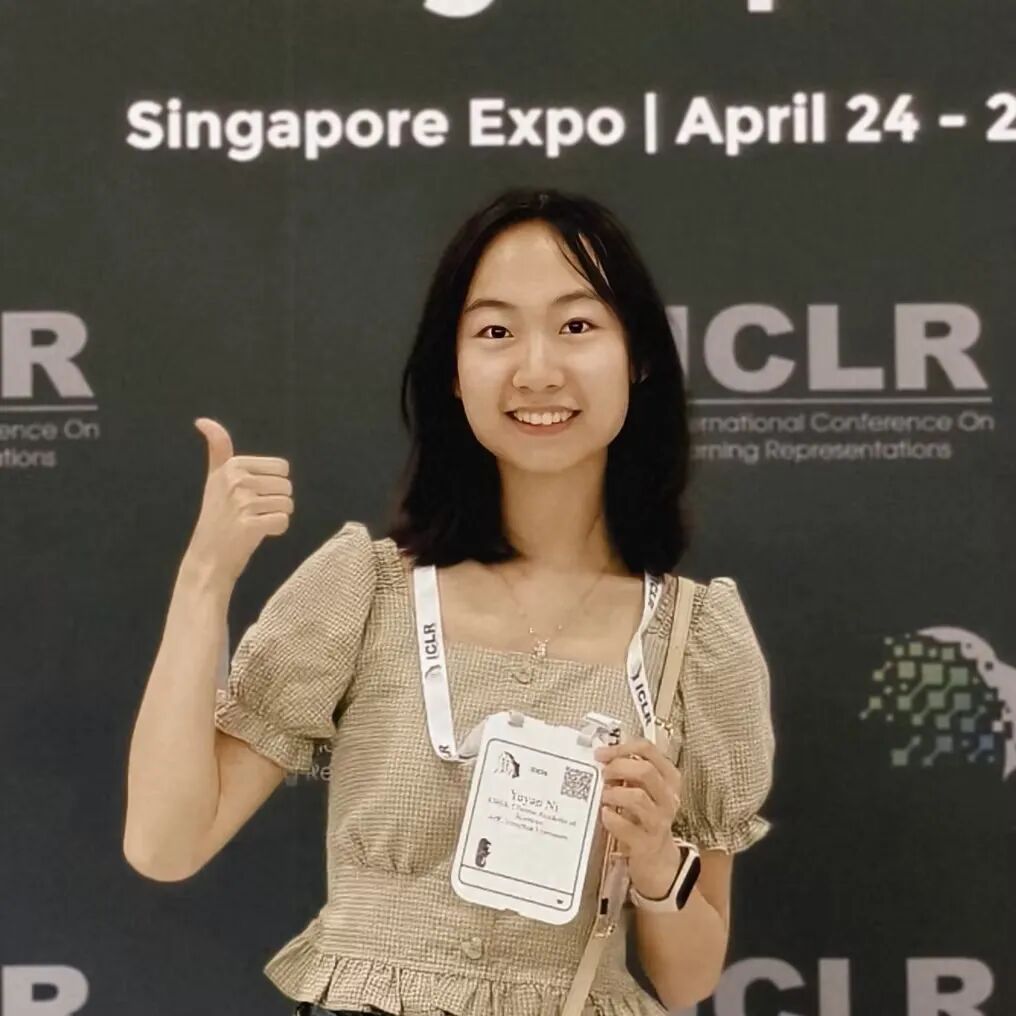
倪雨嫣,中国科学院数学与系统科学研究院博士,师从马志明院士与清华大学智能产业研究院(AIR)兰艳艳教授,研究兴趣包括深度生成模型、表示学习、AI for Science。在人工智能顶级期刊Nature Machine Intelligence,人工智能顶级会议Neurips、ICML、ICLR发表论文十余篇,并担任会议审稿人。